Alur Sistem & Diagram Metode
1. Alur Sistem Proyek Ini
Dua diagram: (a) alur pelatihan federated learning end-to-end
(pipeline riset), (b) alur verifikasi jalur produksi
(server_bridge.py) yang terpisah dari (a).
flowchart TB
    subgraph SRC["Sumber Data"]
        direction LR
        CMU[("CMU Keystroke
51 subjek")]
        BAL[("Balabit Mouse
10 subjek")]
    end

    CMU --> SPLIT["Split anti-leakage
(per-subjek / per-file sesi)"]
    BAL --> SPLIT
    SPLIT --> FEAT["Ekstraksi fitur
93D keystroke + 9D mouse = 102D"]
    FEAT --> CLIENTS["N × FederatedClient
(1 per subjek)"]

    subgraph FLLOOP["Federated Learning — per ronde"]
        CLIENTS --> LOCALTRAIN["Train lokal
(+FGSM adversarial, opsional)
(+DP-SGD opacus, opsional)"]
        BYZ[["Byzantine Attacker
noise-injection / sign-flip"]] -. menyusup .-> LOCALTRAIN
        LOCALTRAIN --> AGG{"Agregasi Server"}
        AGG -->|FedAvg| GMODEL["Model Global"]
        AGG -->|Trimmed-mean| GMODEL
    end

    GMODEL -->|"Zero-shot: AUC = 0.5000
(belum ada sinyal individu)"| PERS
    PERS["Personalisasi per-user
fine-tune + early stopping
(train/val split internal)"] --> EVAL["Evaluasi
Leave-one-client-out
MSE → ROC → EER / AUC / FRR@FAR"]

    style BYZ fill:#f8d7da,stroke:#b02a37,color:#5c1a1a
    style GMODEL fill:#fff3cd,stroke:#c9a227,color:#5c4a00
    style EVAL fill:#d1e7dd,stroke:#146c43,color:#0a3622
flowchart LR
    ENR["Enrollment
8 sampel"] --> LOO["Kalibrasi threshold
leave-one-out
3 kelompok fitur terpisah"]
    LOO --> FIT["Fine-tune final
(+DP-SGD, opsional)"]
    FIT --> V{"Verifikasi
AND 3-arah"}
    V -->|"keystroke OK DAN
mouse-kinematik OK DAN
mouse-adherence OK"| G["GENUINE"]
    V -->|"salah satu saja gagal"| I["IMPOSTOR"]

    style G fill:#d1e7dd,stroke:#146c43,color:#0a3622
    style I fill:#f8d7da,stroke:#b02a37,color:#5c1a1a
2. Screenshot Diagram Metode — 4 Paper ScienceDirect
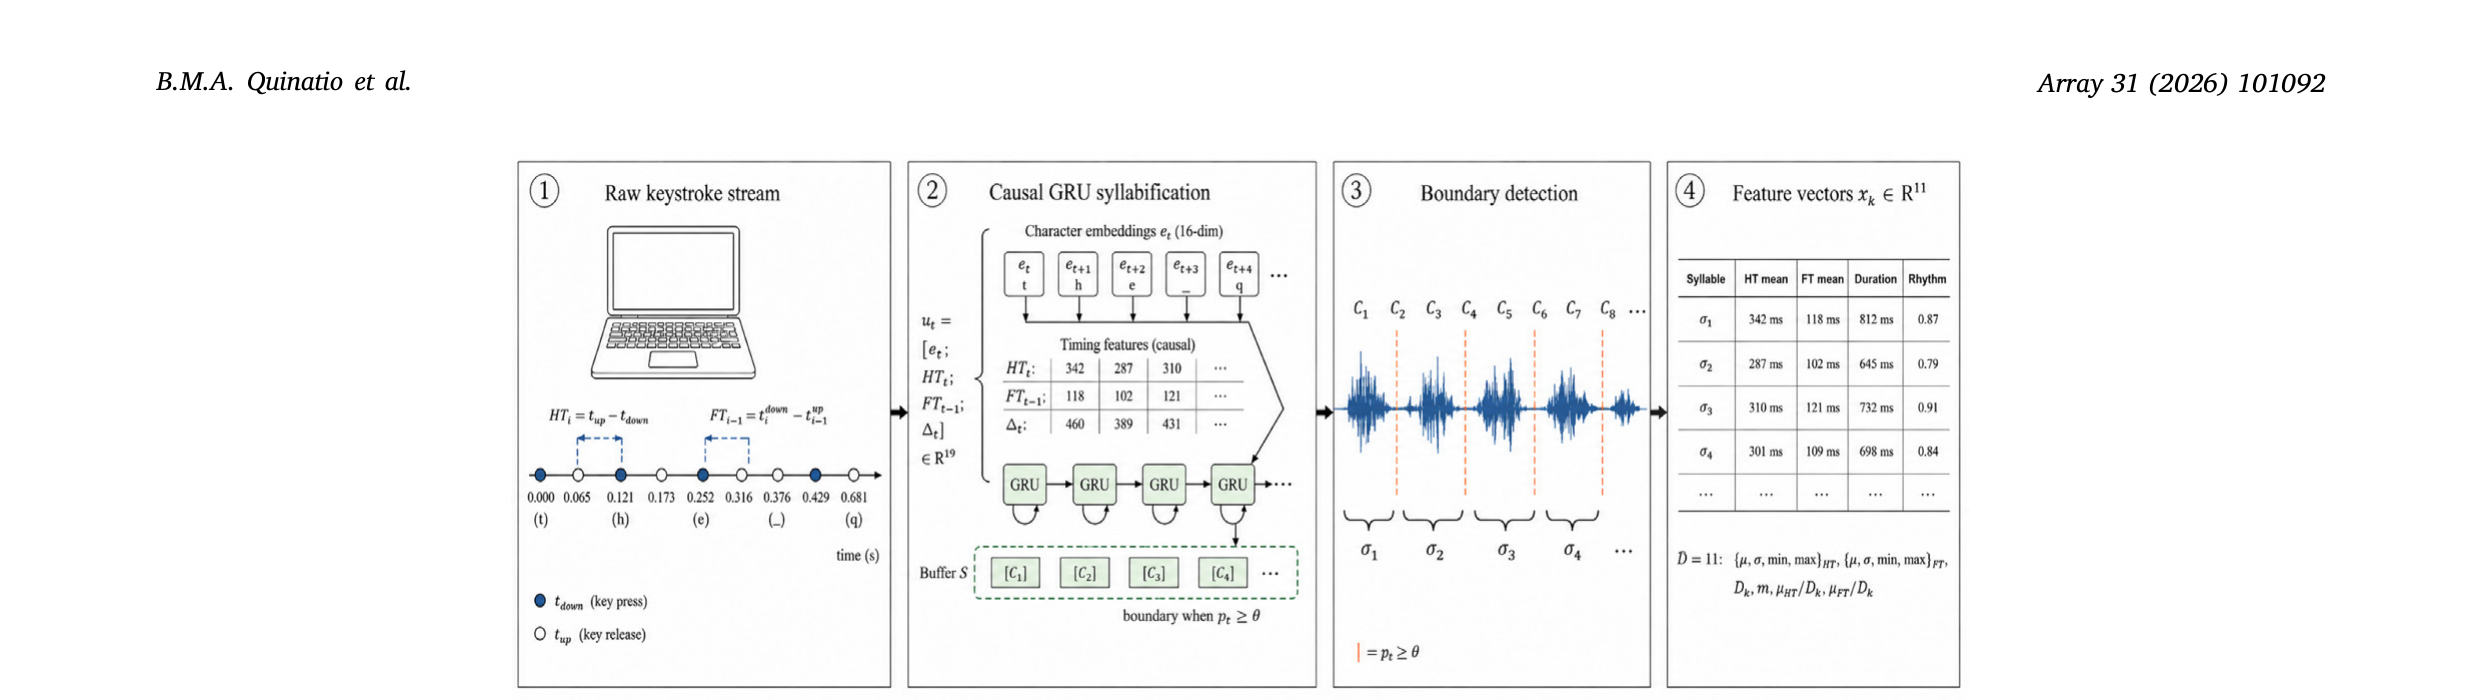
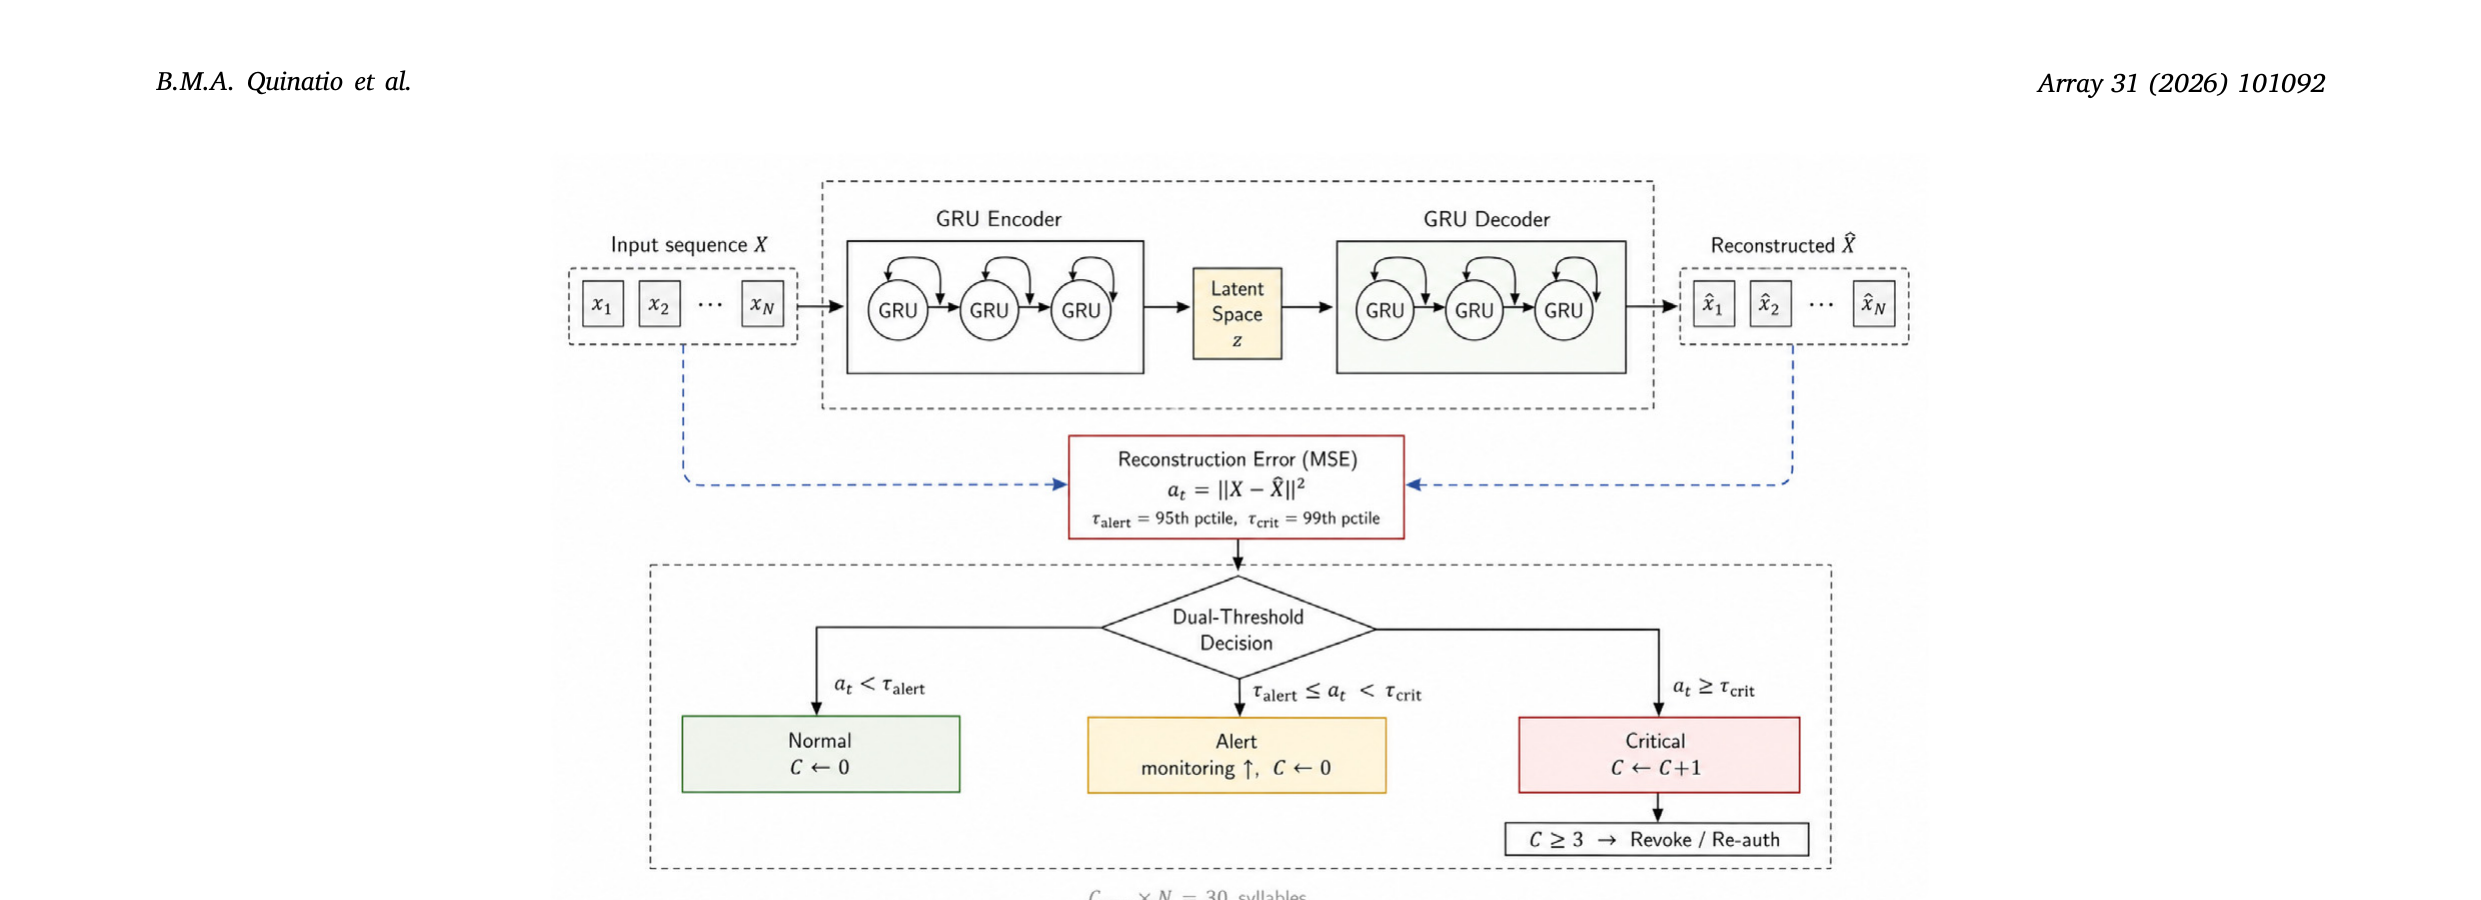
Pembanding LANGSUNG paling dekat dengan BiometricAutoencoder proyek ini
— sama-sama autoencoder one-class, keputusan lewat reconstruction-error (MSE) vs threshold.
Beda: mereka pakai GRU (rekuren, per-window syllable) bukan MLP; EER
mereka 3.8% ± 1.4% (Buffalo, 148 user, model dilatih LANGSUNG
per-user tanpa FL) jauh lebih rendah dari EER proyek ini (~26–28%,
leave-one-client-out setelah FL) — tapi ini justru MENGUATKAN
temuan “Zero-shot vs personalized” kita sendiri: model yang
dilatih langsung per-pengguna (tanpa lewat agregasi FL dulu) bisa jauh
lebih diskriminatif, karena tidak perlu memulihkan sinyal dari titik
awal “populasi rata-rata”. Pola paling berharga utk
diadopsi: dual-threshold decision (Alert 95th percentile +
Critical 99th percentile + counter C≥3 berturut-turut
baru revoke) — jauh lebih graceful dari keputusan biner
GENUINE/IMPOSTOR proyek ini saat ini.
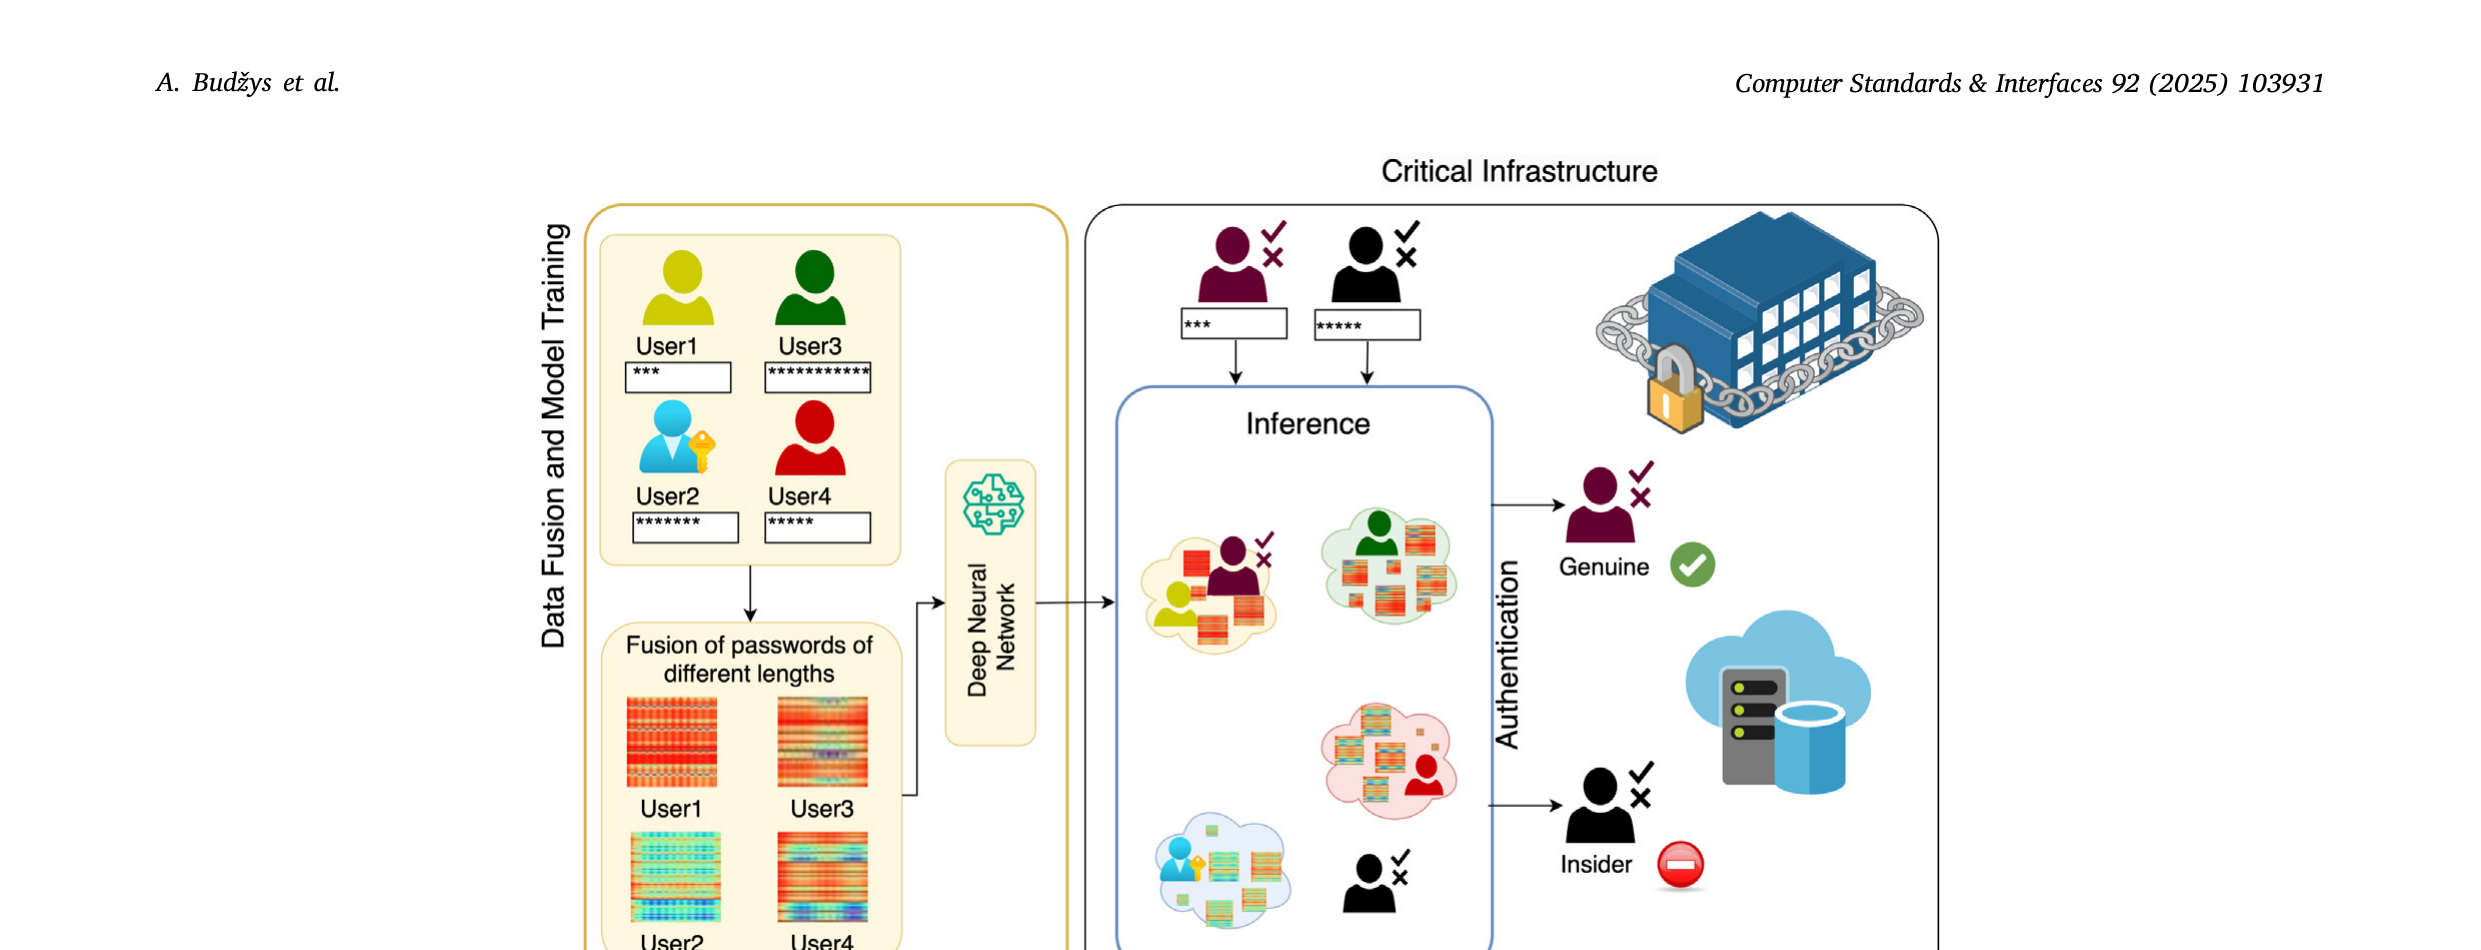
Fusion 3 dataset keystroke berbeda (CMU 51 user + KeyRecs 99 user + GREYC-NISLAB 110 user, total ∼54.000 rekam password) memakai interpolasi linear untuk menyamakan panjang fitur (37 timestamp), lalu GAFMAT (transformasi Gabor filter time-series→citra) + Siamese Neural Network (13 layer CNN, 2,8 juta parameter) + triplet loss. EER terbaik 13.281% pada data fusion tak-terlihat (uji SELALU pada user baru, bukan validasi user yang sama — disiplin evaluasi yang sama dengan leave-one-client-out proyek ini). Relevansi: fusion lintas-dataset mereka analog dgn fusion lintas-modalitas (keystroke 93D + mouse 9D) proyek ini — sama-sama masalah “menyamakan panjang/skala fitur sebelum digabung ke satu model”.
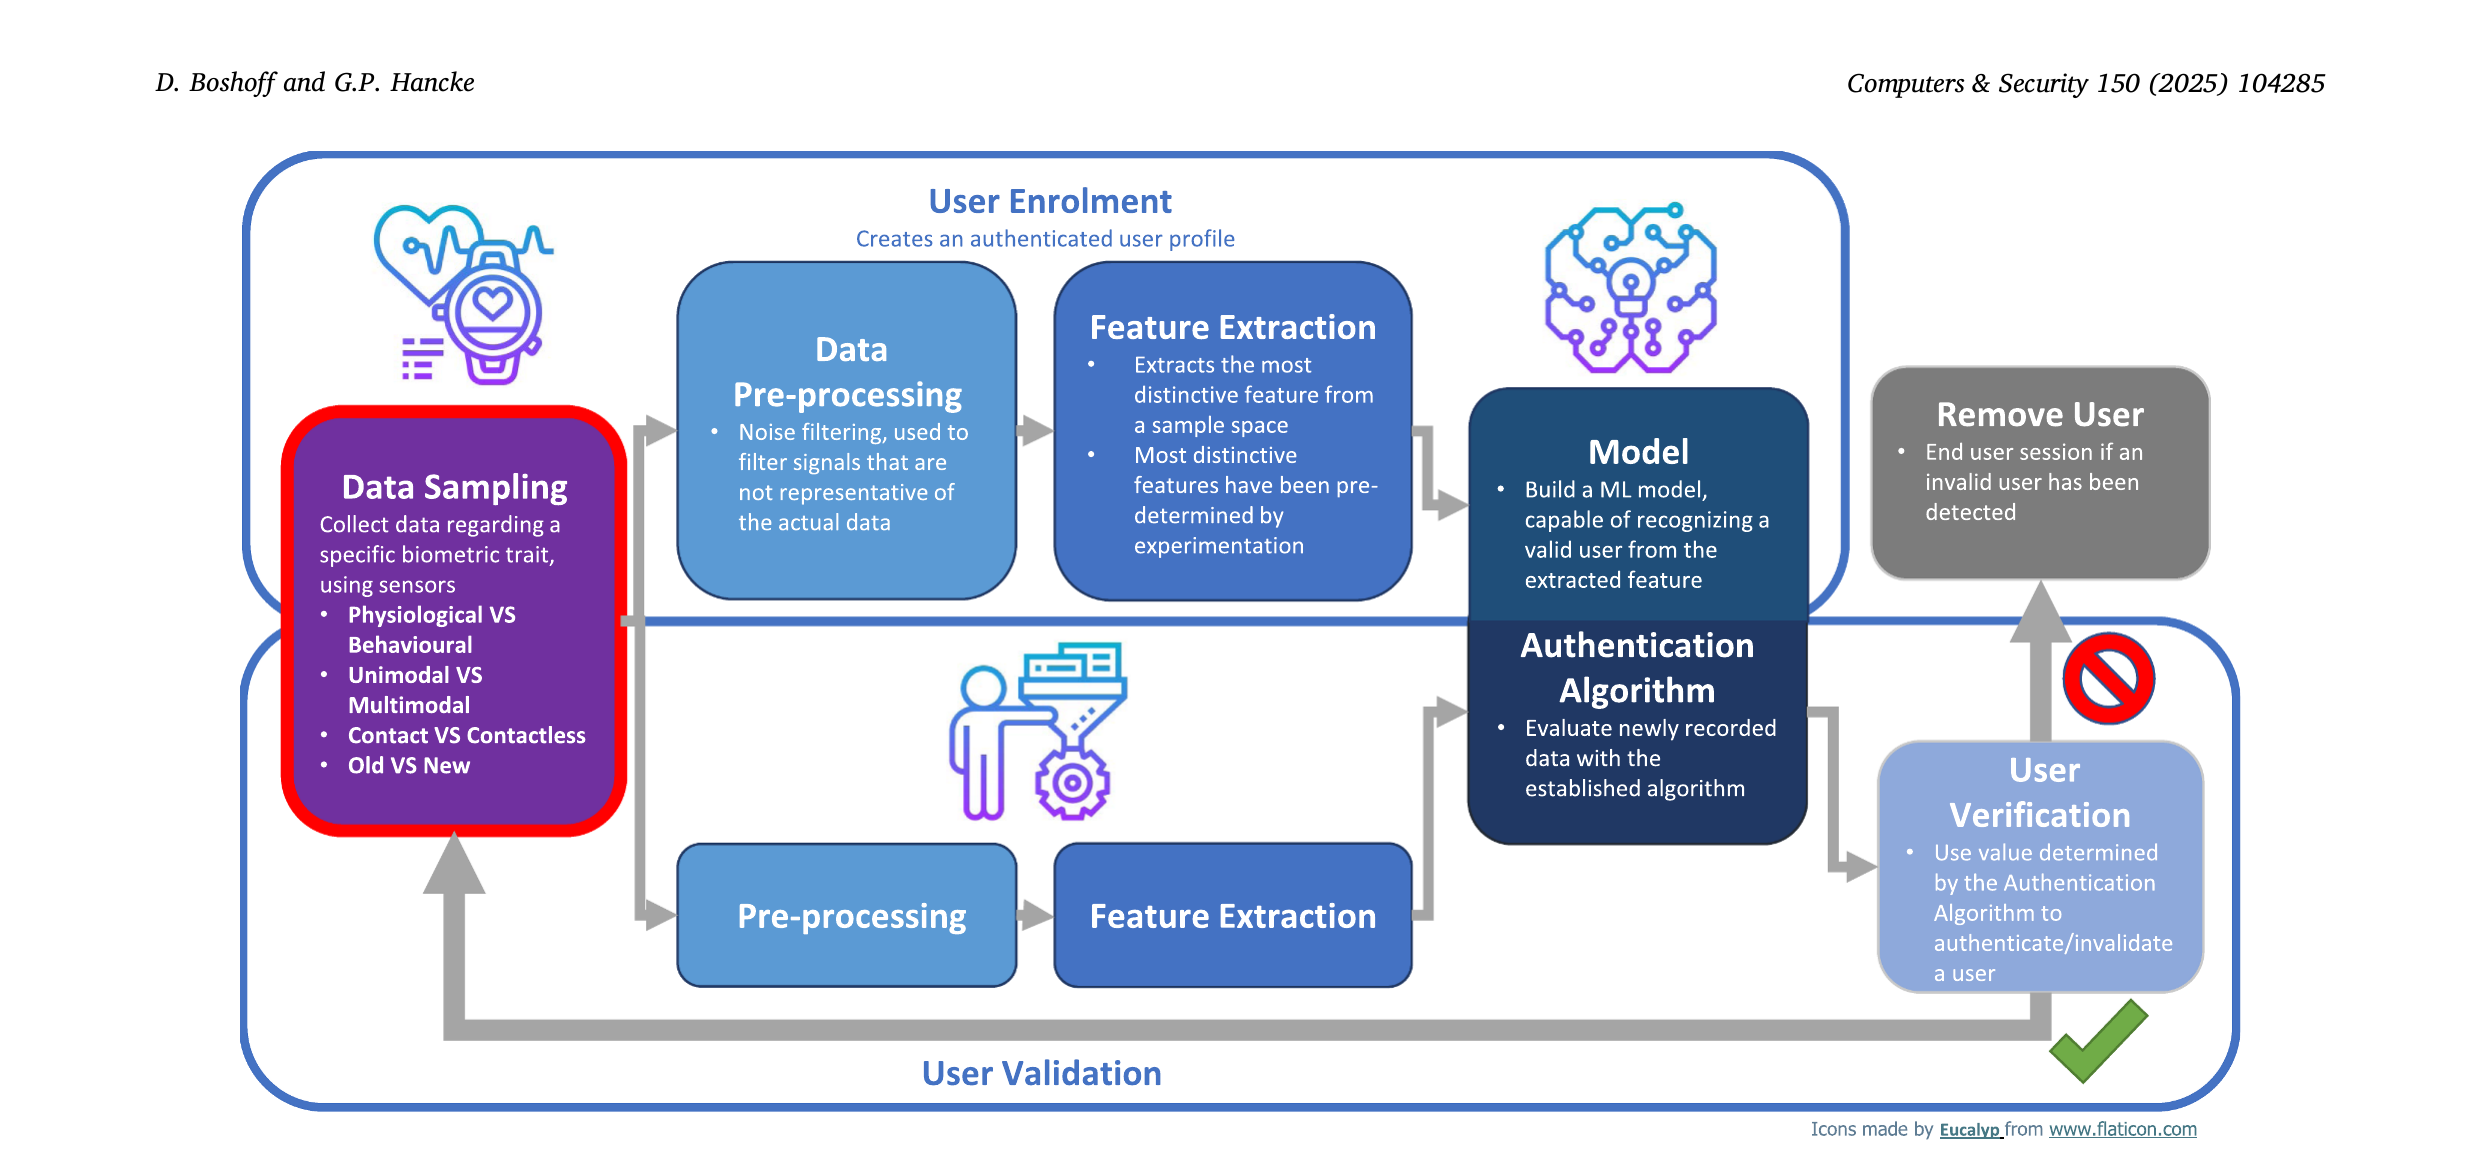
Ini bukan satu sistem, tapi kerangka arsitektur rujukan hasil
survei 80 paper CBA (2018–2024). Berguna sebagai peta:
proyek ini bisa dipetakan langsung ke 4 fase yang sama — Data
Sampling (CMU+Balabit), Pre-processing+Feature Extraction
(extract_keystroke_vector/extract_mouse_vector),
Model (BiometricAutoencoder + FL), User Verification (AND
3-arah). Temuan kuantitatif: sistem physiological rata-rata FMR/FNMR
lebih rendah (2%/6%) drpd behavioral (mis. keystroke+mouse
milik proyek ini) — kerangka jujur untuk menjelaskan kenapa EER
kita tidak akan pernah serendah sistem fingerprint/iris, ini batas
intrinsik modalitas behavioral, bukan kegagalan implementasi.
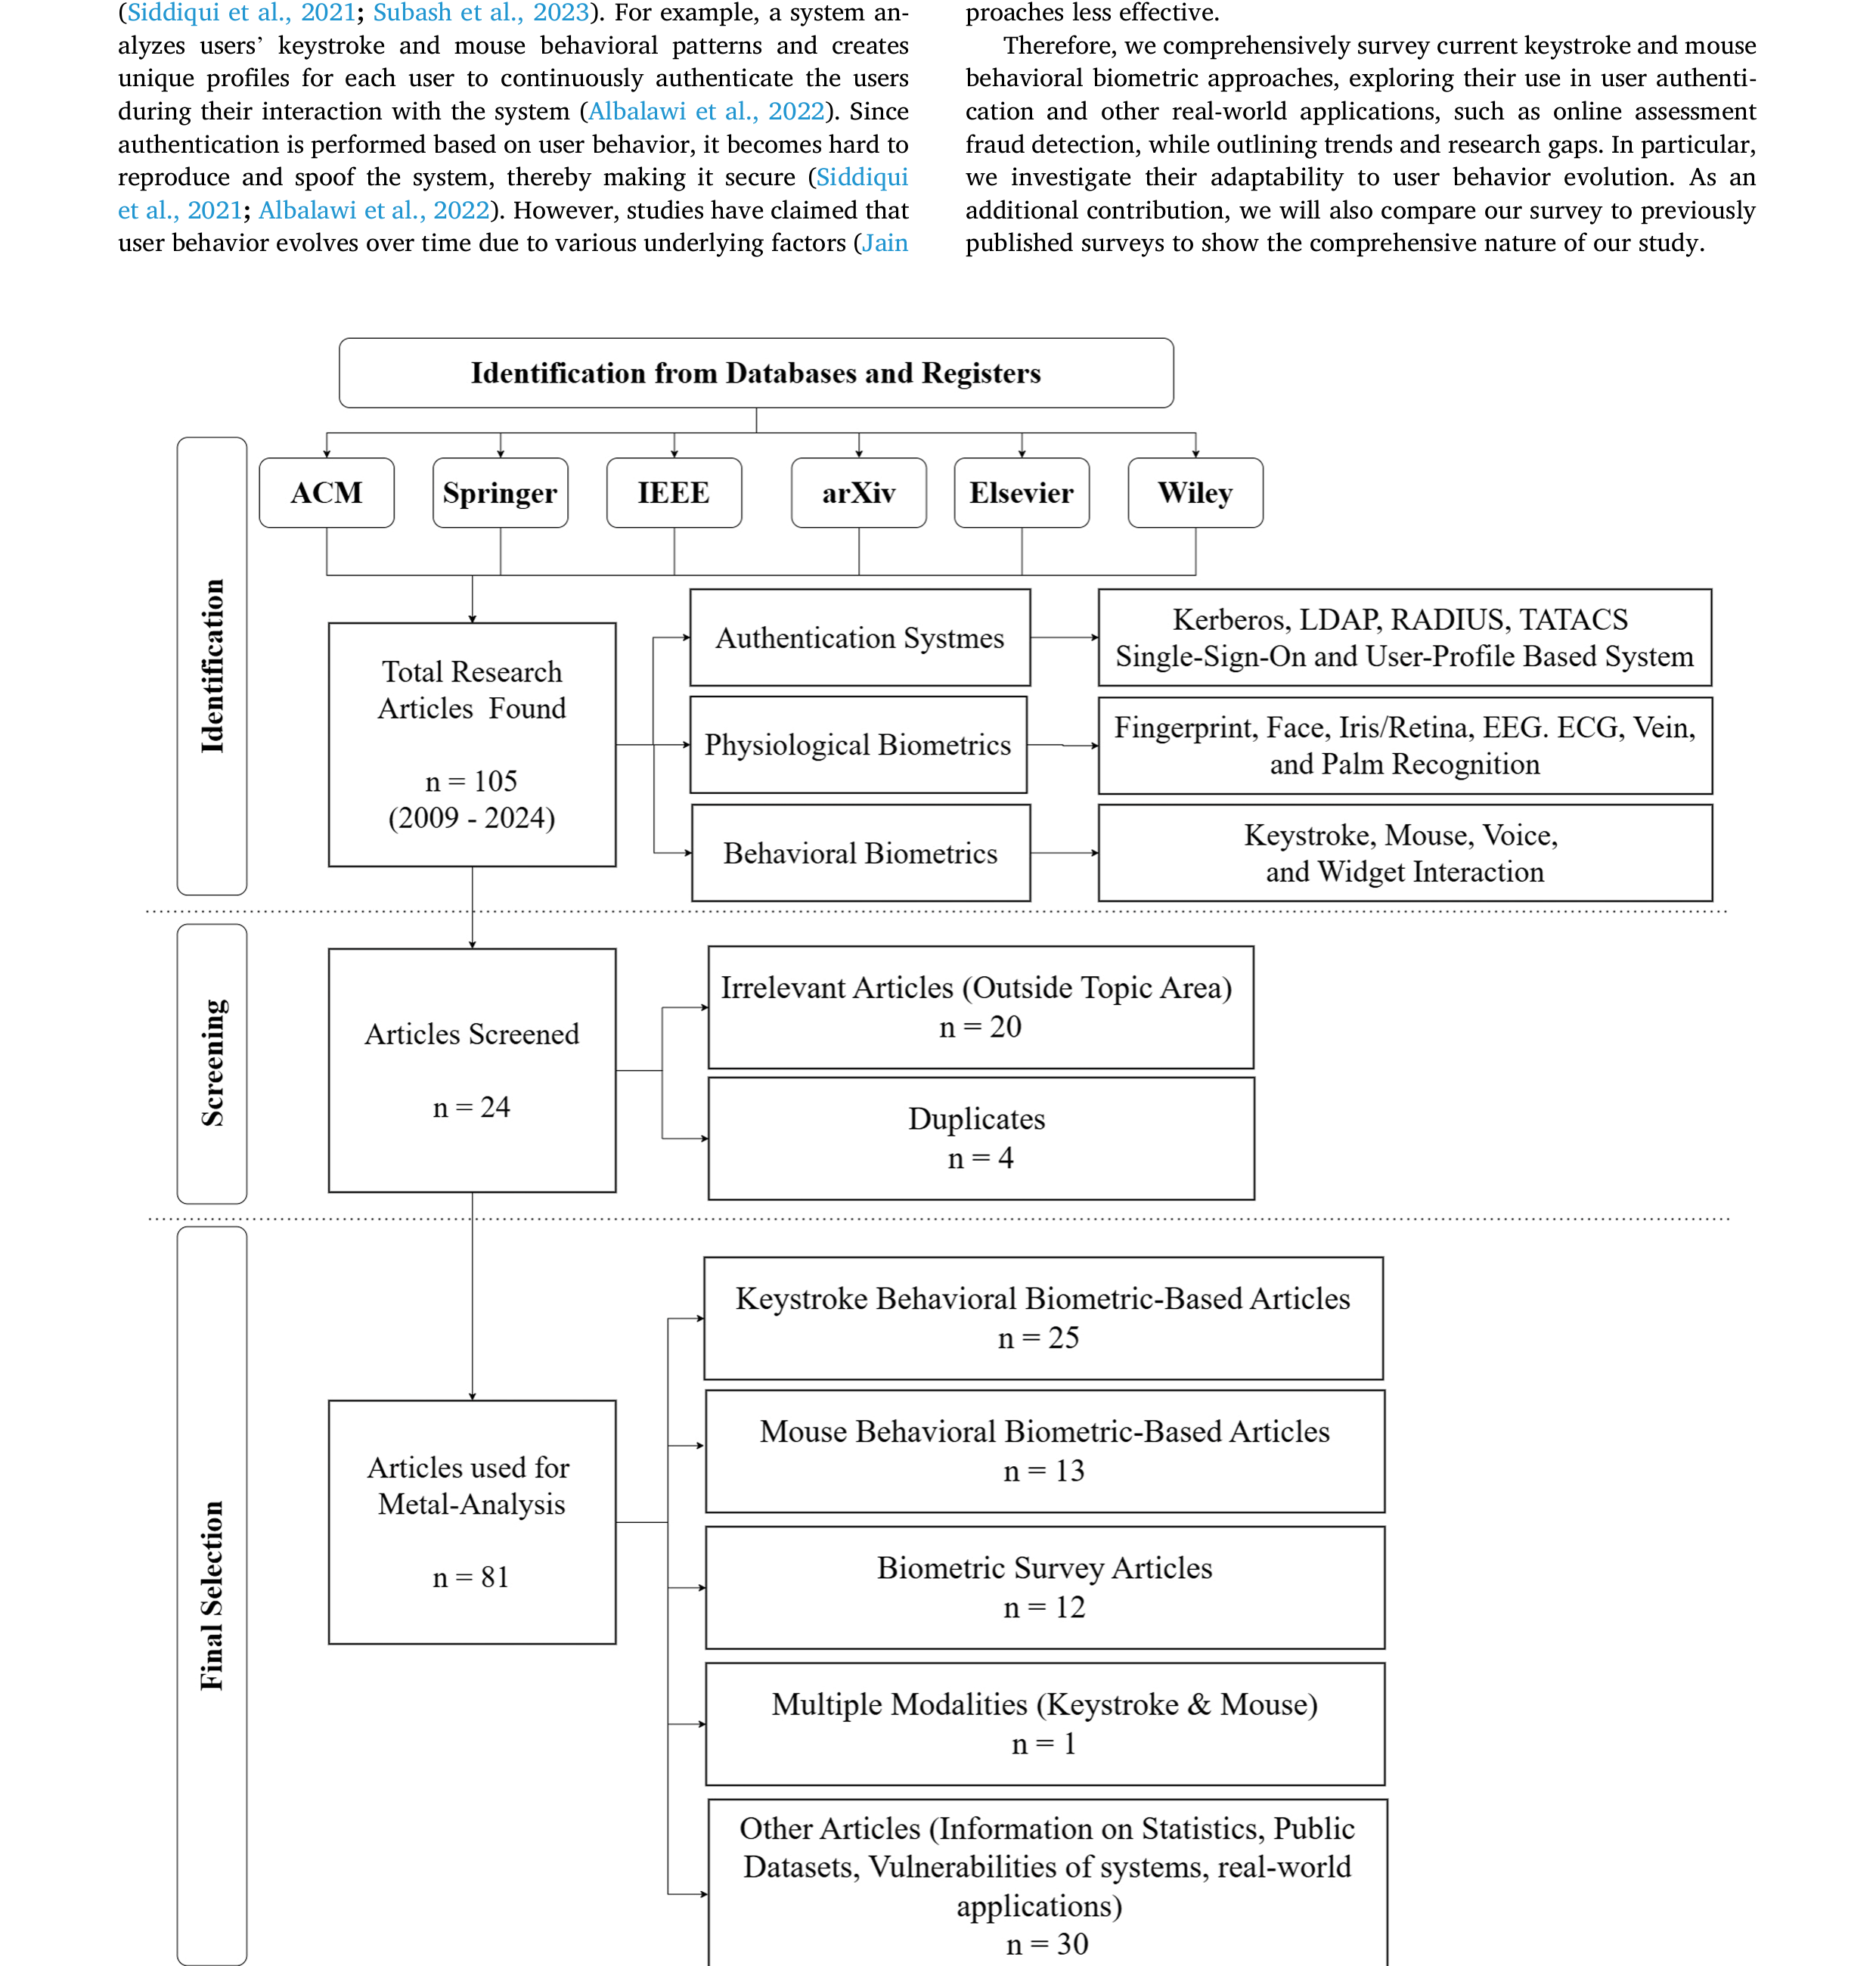
Temuan utama survei ini: dari 25+13 studi keystroke/mouse yang ditinjau, HANYA 3 yang punya mekanisme adaptasi terhadap evolusi perilaku pengguna dari waktu ke waktu — dan TIDAK SATU PUN dari 13 studi mouse dynamics (Tabel 9 paper ini) punya mekanisme adaptasi sama sekali. Proyek ini juga TIDAK punya mekanisme adaptasi jangka panjang (model dilatih sekali saat enrollment, tidak diperbarui seiring waktu) — celah yang sama, didukung bukti bahwa ini memang celah literatur luas, bukan kelalaian proyek ini secara spesifik.
3. Ringkasan Angka Terverifikasi (bukan snippet lagi)
| Paper | Arsitektur | EER / Metrik kunci | Dataset |
|---|---|---|---|
| Quinatio et al. (2026) | AE-GRU one-class + syllabifikasi kausal, ~53.000 parameter | EER 3.8% ± 1.4%, latensi 22±4 karakter, <5ms/window | Buffalo, 148 partisipan (free-text) |
| Budžys et al. (2025) | Siamese NN (CNN 13-layer, 2.8M param) + GAFMAT + triplet loss | EER terbaik 13.281% (data fusion tak-terlihat) | CMU(51)+KeyRecs(99)+GREYC(110), ∼54.000 rekam |
| Boshoff & Hancke (2025, survei) | N/A — taksonomi arsitektur CBA generik dari 80 paper | Physiological avg FMR/FNMR 2%/6% vs Behavioral 9.9%(FNMR) | 80 paper CBA disurvei (2018–2024) |
| Subash et al. (2026, survei) | N/A — survei adaptabilitas 81 artikel (PRISMA) | 0 dari 13 studi mouse dynamics punya adaptasi perilaku | 105 artikel disaring → 81 dianalisis |
| Proyek ini | MLP autoencoder (latent=16) + FL (FedAvg/trimmed-mean) + DP-SGD + FGSM adv. training | EER ~26–28% (personalisasi, leave-one-client-out) | CMU(51)+Balabit(10) |